## Son idée
Vendre des t-shirts pour financer ses études.
Un design
❤.js
### Comment feriez-vous ?
Gardez votre réponse. On y revient dans un quart d'heure.
### Qui suis-je ?
* Un Tech
* Développeur de Jumplyn
* Enseignant en Telecom à l'INSA Lyon
## Avertissements, déclarations et conseils
---
### Utilisation des machines de l'INSA
N'utilisez pas des machines que vous n'avez pas en visuel et sur laquelle il y a un utilisateur sauf dans le cadre d'un TD/TP où c'est l'objectif du TD/TP.
Plus globalement, faites très attention lorsque vous utilisez plusieurs machines en dehors d'une session de TD/TP. Cela peut aller à l'encontre de la charte informatique de l'INSA.
---
### Point de vue
Ce cours est mon point de vue sur le sujet.
Il est biaisé par mon expérience personnelle, mes centres d'intérêts et les retours faits par mes collègues et étudiants.
N'hésitez pas à aller voir ailleurs.
---
### Déclaration d'intérêts
Je vais vous montrer trois fois **Jumplyn** — la plateforme sur laquelle vous déposez vos conventions de stage.
Je la développe. L'autre enseignant de cette matière la dirige.
Ce n'est pas une démonstration commerciale : c'est le seul système dont je peux vous ouvrir le capot et répondre à toutes vos questions.
---
### Technologie
L'écosystème évolue très vite. Nous nous concentrons sur les concepts fondamentaux illustrés par les technologies dominantes en 2026.
---
### Javascript
Les TDs/TPs utiliseront majoritairement Javascript.
---
## Conseils
Prenez des notes.
---
## Interrompez-moi
Posez des questions quand les choses vous paraissent floues.
Posez des questions quand je vais trop vite.
## La matière
5 cours, 7 TD, 2 TP.
Deux enseignants : Damien Reimert (DRE) et Stéphane Frénot (SFR).
Responsable du cours : Stéphane Frénot (SFR).
---
### Les 5 cours
| | Sujet | |
|---|---|---|
| Cours 1 | Grands systèmes | DRE |
| Cours 2 | Communications | SFR |
| Cours 3 | Consensus | SFR |
| Cours 4 | Pair à pair (P2P) | SFR |
| Cours 5 | Blockchain | DRE |
---
### Les 7 TD et 2 TP
| | Sujet | |
|---|---|---|
| TD1 | RPC | SFR |
| TD2 | Scraping | DRE |
| TD3 | Spark | DRE |
| TD4 | Horloges | SFR |
| TD5 | Raft | SFR |
| TD6 | DHT | DRE |
| TD7 | Bitcoin | DRE |
| TP1 / TP2 | Blockchain (4h + 4h) | DRE |
---
### Ce n'est pas une liste de sujets
C'est **une seule histoire**, racontée dans l'ordre :
le retrait progressif du serveur central.
---
### Le retrait progressif du serveur central
| Séance | Ce qui disparaît |
|---|---|
| RPC | rien : il y a un serveur, on l'appelle |
| Scraping | le serveur ne coopère plus |
| Spark | le calcul quitte la machine unique |
| Horloges | il n'y a plus de temps commun |
| Raft | il y a plusieurs serveurs, le chef est élu |
| DHT | il n'y a plus de chef du tout |
| Bitcoin | il n'y a plus personne à qui faire confiance |
---
### Gardez cette carte
À chaque séance, posez-vous la question :
**qu'est-ce que je n'ai plus le droit de supposer ?**
C'est tout le cours.
## Évaluations
---
### Le format
* À chaque TD/TP
* à 8h01 / 10h11 / 14h01 / 16h11 (pour les miens)
* Questions projetées au tableau
* entre 5 et 10 minutes
* Sur tout ce qui a été vu avant, cours et TD/TP
* Sur papier, pensez à amener du papier et un stylo
* Sans document, sans électronique.
---
### Pourquoi à 8h01 ?
Pour que la séance commence à l'heure, et qu'on ne perde pas dix minutes.
Ce n'est pas une sanction : c'est la seule solution pour tout faire en 1h50.
---
### Pourquoi sans document ?
Ce qu'on vérifie, ce n'est pas ce que vous savez **retrouver**.
C'est ce que vous avez **compris** — ce qui vous reste quand vous n'avez rien sous la main.
---
### Pourquoi en début de séance ?
L'évaluation porte sur ce qui a **déjà** été vu.
Elle vous oblige à relire avant de venir. C'est là que l'essentiel de l'apprentissage se fait.
## Et l'IA ?
---
### Ma position, tout de suite
Ce cours est écrit par moi, avec l'aide d'une IA pour des recherches et pour générer des images.
Le sujet du TD scraping a été remis en état en 2026 par une IA : c'est elle qui a constaté que l'ancien chemin était mort, qui a trouvé le nouveau, et qui a réécrit une partie du code.
---
Pour Spark, c'est Claude qui a écrit le sujet.
---
### Donc oui, une IA sait faire les TD
Si vous lui demandez, vous aurez un résultat qui marche en quelques minutes.
Ce n'est pas la peine de faire semblant du contraire, et ce n'est pas la peine de me le cacher.
---
### Mais ce n'est pas ce qu'on vous demande
**L'objectif n'est pas d'arriver au résultat, c'est de comprendre le chemin.**
---
### Ce dont vous aurez besoin, vous
* pourquoi un programme qui marchait ne marche plus ;
* pourquoi ça tombe juste sur un cas et à côté sur un autre ;
* ce que vous avez le droit de collecter, et ce que vous devriez refuser de collecter ;
* quel maillon de votre chaîne va casser en premier — et comment vous le saurez.
Aucune de ces questions ne se répond en lisant la sortie d'un programme, même correct.
---
### Et ce sont celles que je vous poserai
L'évaluation porte sur le chemin, pas sur le livrable.
---
### La règle
Utilisez l'IA si elle vous aide — mais comme **un collègue à qui vous demandez des comptes**, pas comme un oracle.
**Vous devez pouvoir expliquer chaque ligne que vous rendez.**
Si vous ne pouvez pas, vous n'avez pas fait le TD : vous avez regardé quelqu'un d'autre le faire.
Introduction
### Revenons à Jean
Il veut vendre ses t-shirts. Il nous accompagne jusqu'à la fin.
À chaque fois qu'il grandit, il perd une certitude — et il découvre un chapitre de la matière.
Monolithique basique
l'application
Monolithique basique
+ la machine
Monolithique basique
+ les clients
Monolithique pas si basique
+ l'hébergeur
Monolithique pas si basique
+ le monde extérieur
Monolithique pas si basique
+ le code qui tourne chez le client
Monolithique pas si basique
Je vous fais grâce du réseau...
En informatique, l'architecture monolithique est un modèle de conception logicielle dans lequel tous les composants d'une application sont étroitement liés et unifiés en une seule base de code et un seul programme exécutable.
### Trois caractéristiques
* **Une seule unité** — interface, logique métier et accès aux données dans le même processus.
* **Couplage fort** — une modification quelque part peut affecter tout le reste.
* **Déploiement unique** — la moindre correction redéploie l'intégralité.
### Ce que ça vous donne, ce que ça vous coûte
| Avantages | Inconvénients |
|---|---|
| Simple à démarrer, à comprendre, à déboguer | La complexité de la base de code croît avec le temps |
| Un seul artefact à déployer | On ne met à l'échelle qu'en dupliquant le tout |
| Appels locaux : pas de réseau, pas de latence, pas de panne partielle | Une partie qui plante peut tout emporter |
### Retenez surtout la troisième ligne
Dans un monolithe, un appel **réussit ou échoue**.
Dès qu'il y a du réseau, il peut aussi **ne jamais répondre** — et vous ne saurez pas s'il a été exécuté.
C'est la seule différence qui compte. Tout le reste du cours en découle.
## Jean a un pic de charge
Son design marche. Il passe à la télé. 50 000 personnes arrivent en dix minutes.
Le serveur tombe.
### Ses options
* **Scaling vertical** : un plus gros serveur. Simple, immédiat, et il y a un plafond.
* **Scaling horizontal** : plusieurs serveurs identiques derrière un répartiteur de charge.
---
### Ce que la deuxième option lui coûte
Deux serveurs, deux mémoires : où est la session de l'utilisateur ?
Deux serveurs, une base : que se passe-t-il quand ils écrivent en même temps ?
Jean vient d'entrer dans les systèmes distribués — sans l'avoir demandé.
### Le même problème, en vrai
**Jumplyn** — la plateforme où vous déposez vos conventions de stage.
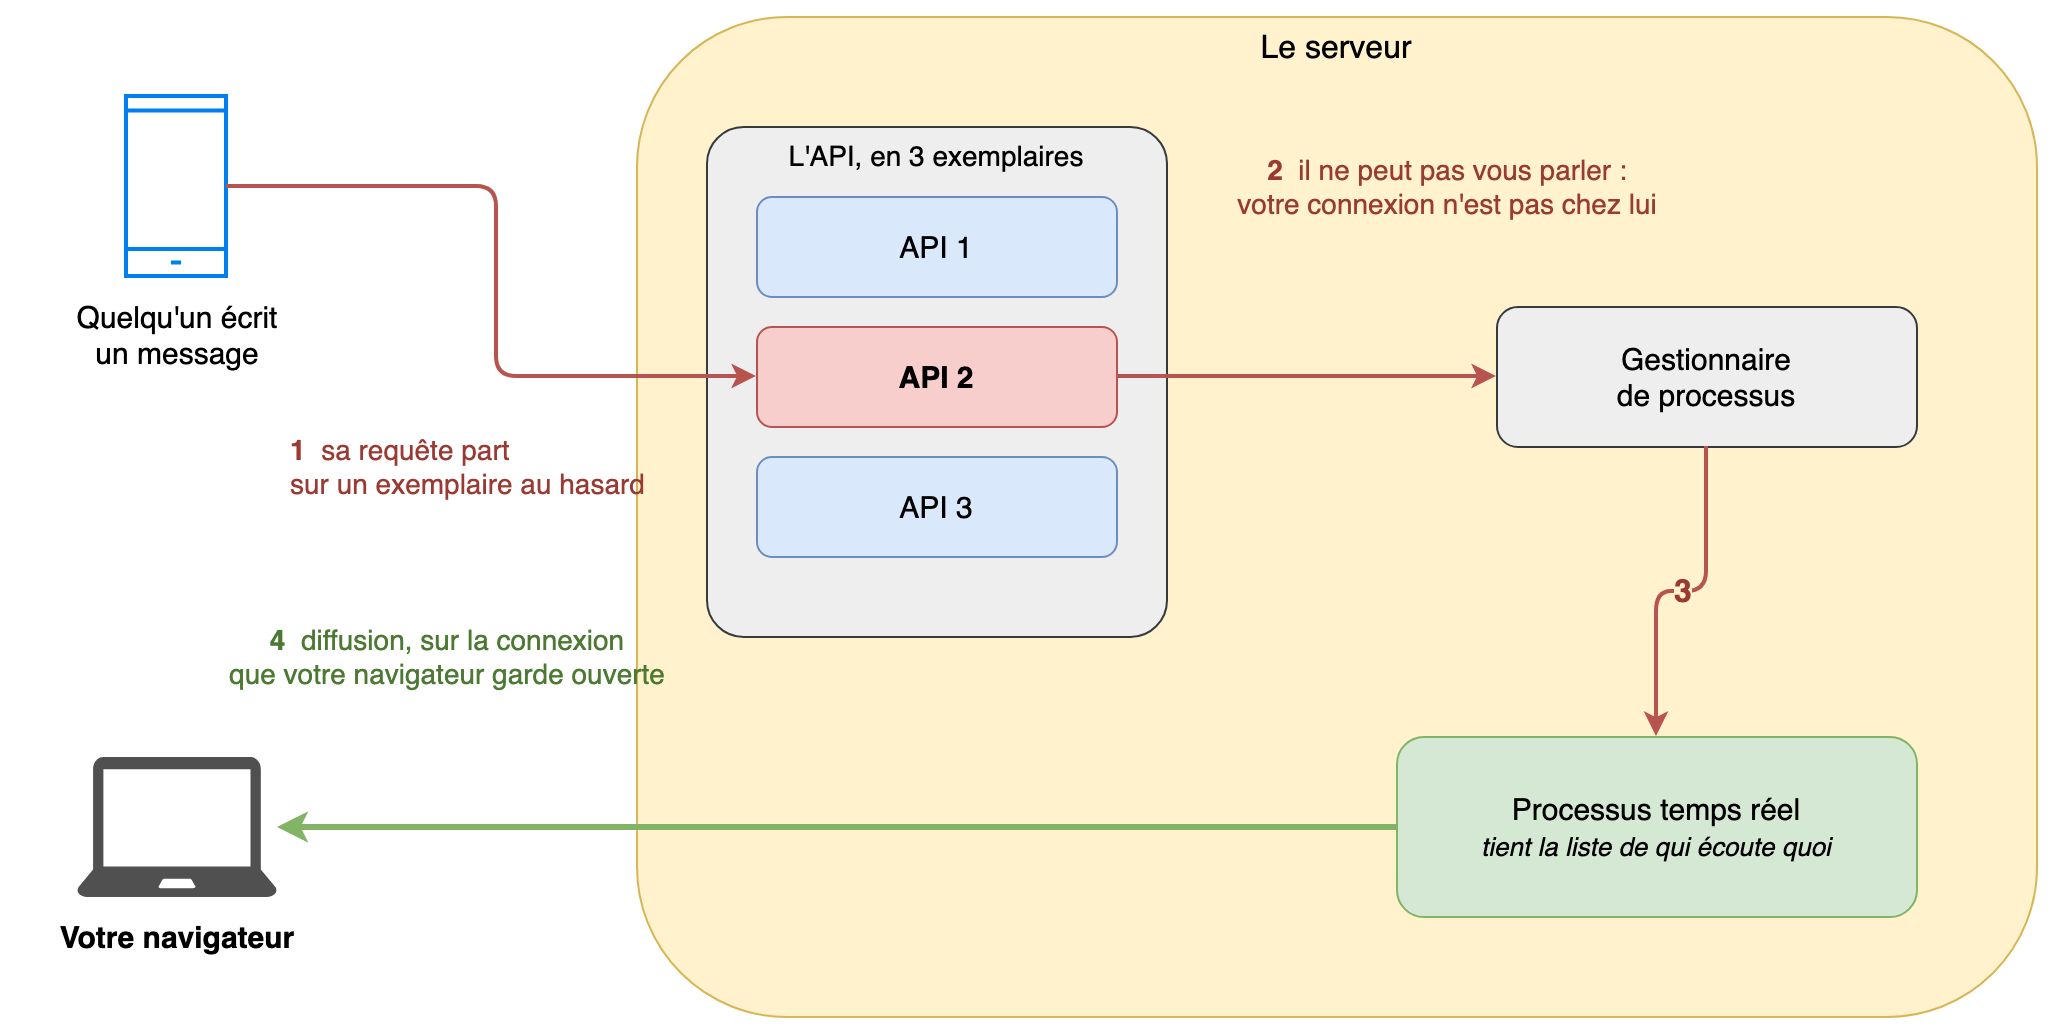
Votre navigateur y garde **une connexion ouverte**, pour voir arriver les nouveautés sans recharger la page.
Mais l'API tourne en **trois exemplaires**. Quand quelqu'un écrit un message, sa requête part sur l'un des trois, au hasard — pas sur celui qui tient votre connexion.
Comment votre écran l'apprend-il ?
Un processus dédié
### Un processus de plus, une responsabilité en moins
Les trois exemplaires de l'API n'ont plus à savoir qui est connecté où. Un seul processus tient cette liste.
C'est la slide d'il y a deux minutes, « deux serveurs, deux mémoires », avec du vrai code derrière.
### Jumplyn en entier
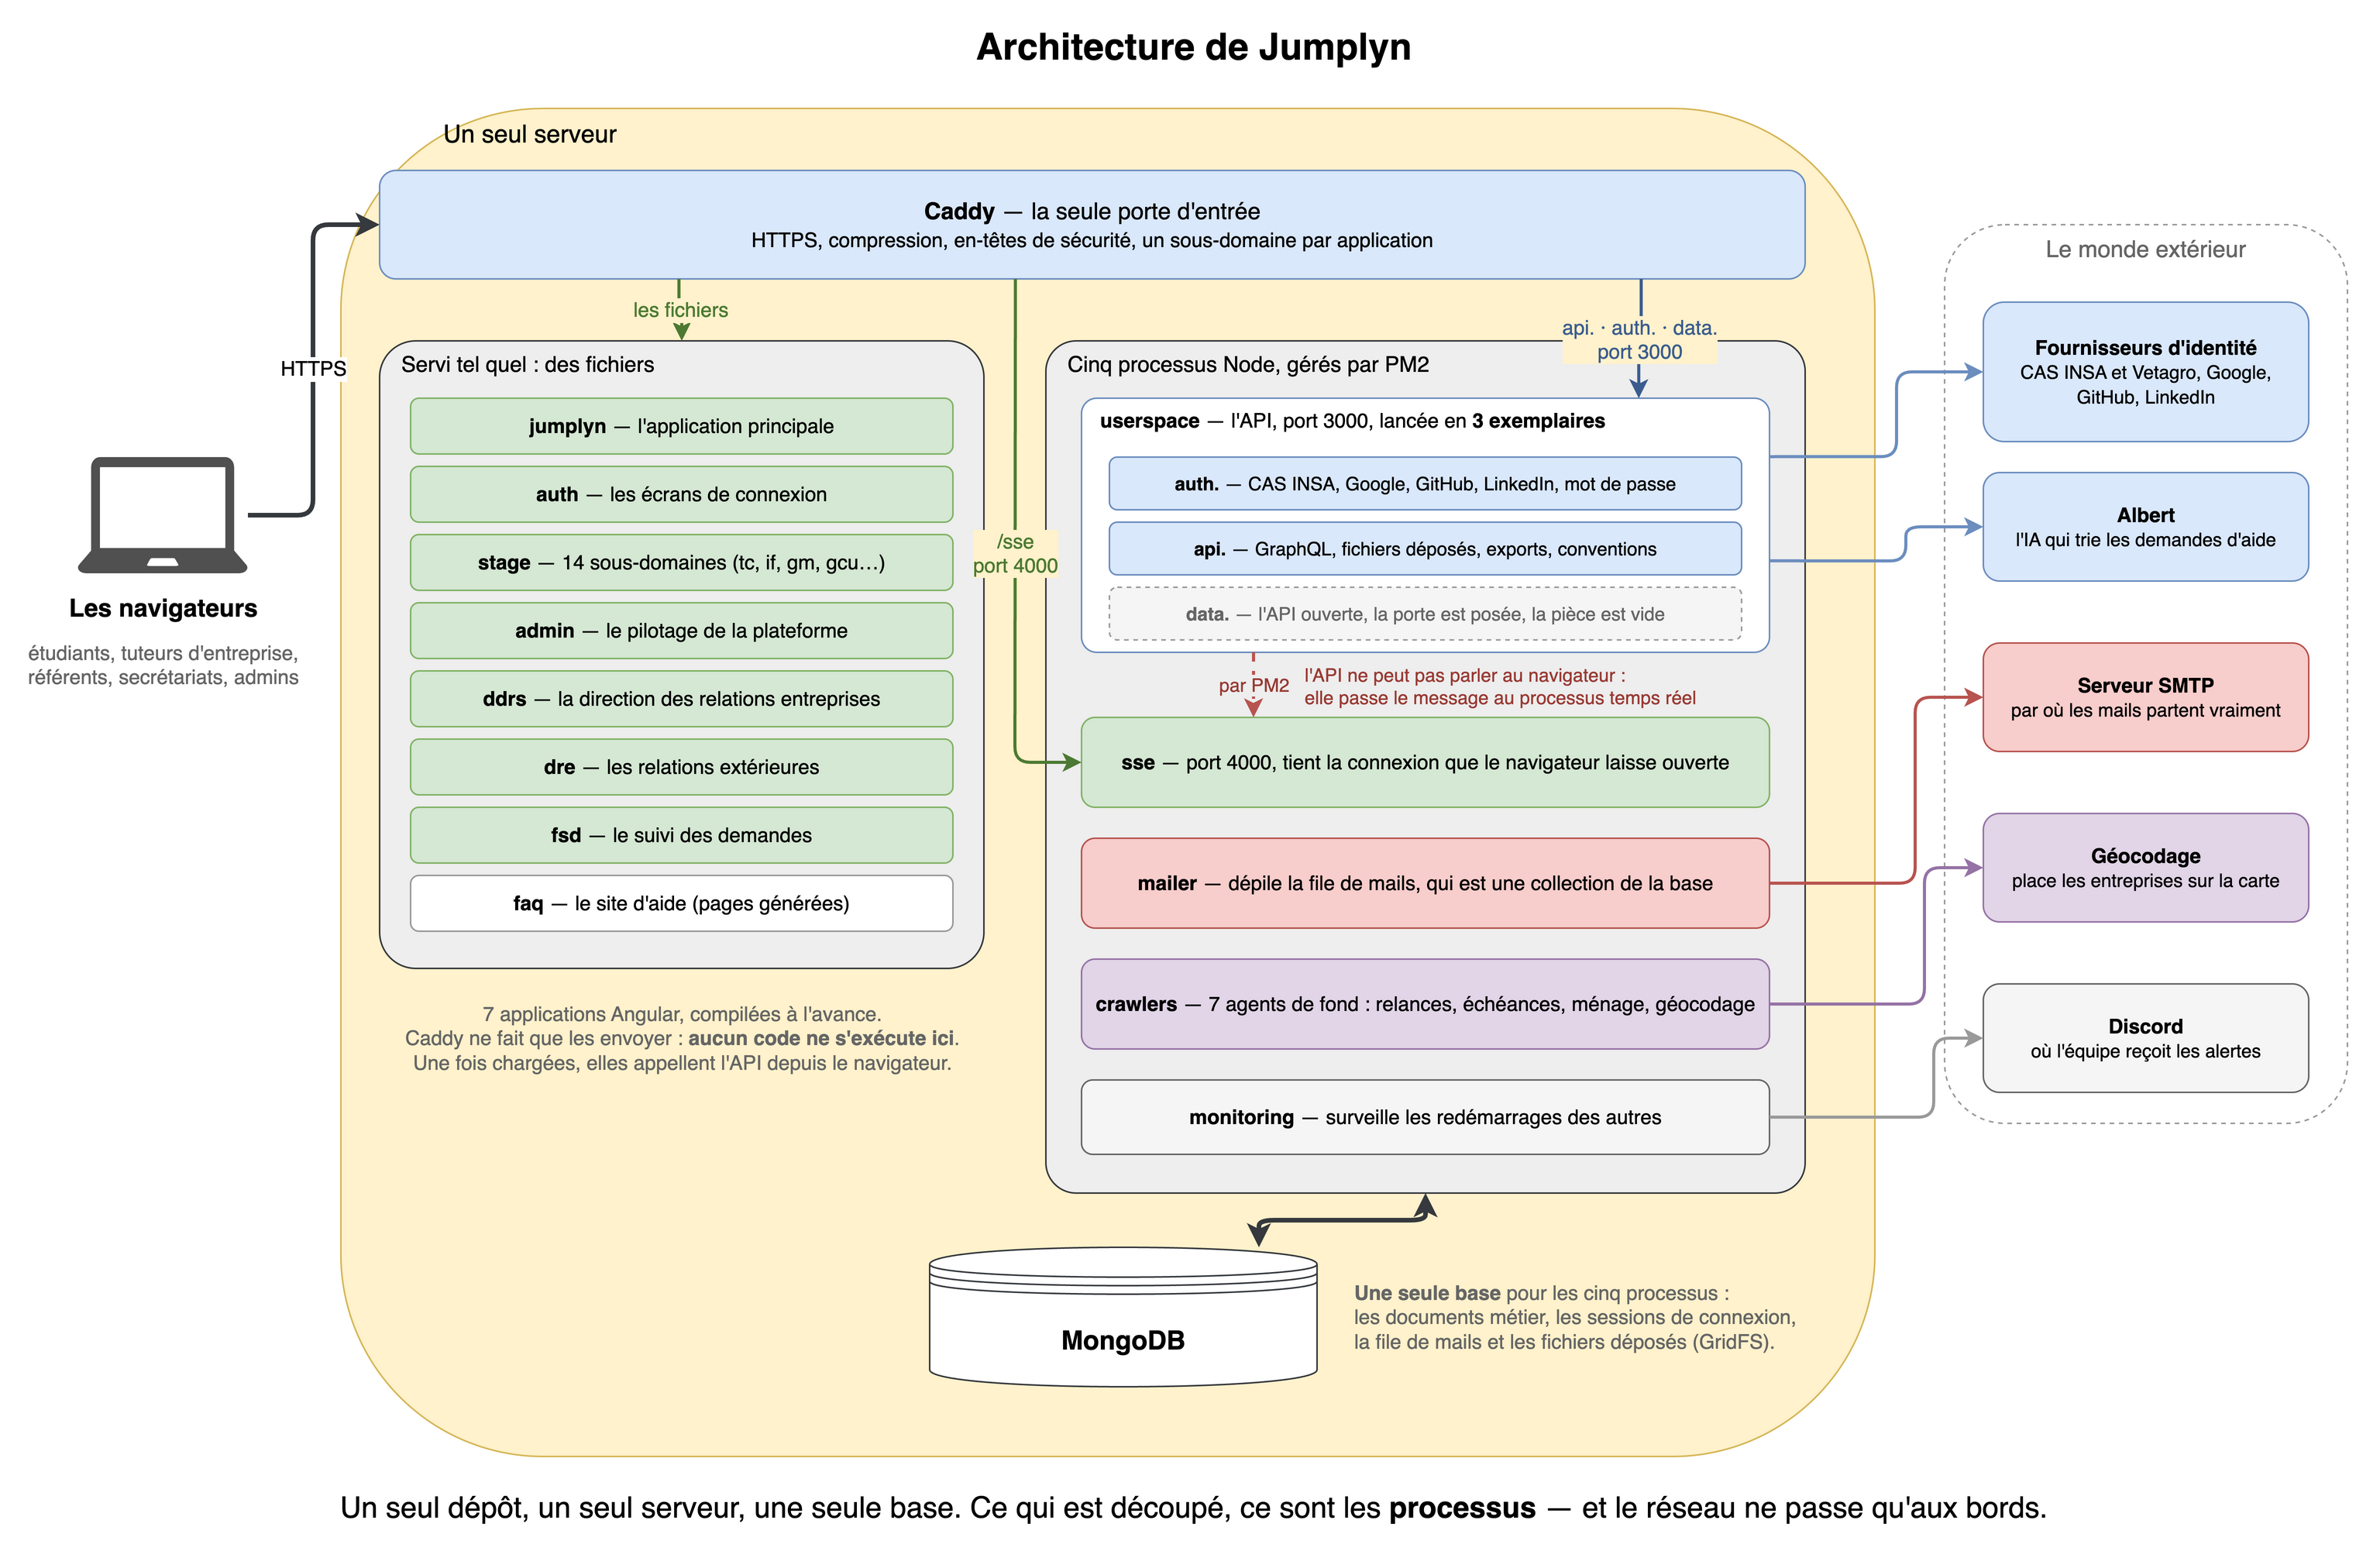
Un seul dépôt, un seul serveur, une seule base. Le monolithe de tout à l'heure, en production.
Ce qui est découpé, ce sont les **processus** — et le réseau ne passe qu'aux bords.
Le processus temps réel de la slide précédente, c'est **sse**. Il est là parce qu'un besoin l'a imposé, pas parce qu'un schéma le demandait.
### Ce n'est pas un problème d'étudiant
Exemple : « Vinted Autumn », le pic de rentrée.
Regardons quelqu'un qui a fait le trajet en entier.
Fondée en Lituanie en 2008, Vinted a débuté son parcours comme un petit projet communautaire pour la vente et l'échange de vêtements d'occasion.
[État de l'architecture en 2015](https://highscalability.com/vinted-architecture-keeping-a-busy-portal-stable-by-deployin/) :
* 7 million users and growing
* 2.5 million monthly active users
* 200 million requests / day (pageviews + API calls)
* 930 million photos
* 80 TB raw space for image storage
* 60 TB HDFS raw space for analytics data
* 70% of traffic comes from mobile apps (API requests)
* 3+ hours / week time spent per member
* 25 million listed items
Over 220 servers bare metal:
* 47 for internal tools (vpn, chef, monitoring, development, graphing, build, backups, etc.)
* 38 for the Hadoop ecosystem
* 34 for image processing and storage
* 30 for Unicorn and microservices
* 28 for MySQL databases, including replicas
* 19 for the Sphinx search
* 10 for resque background jobs
* 10 for load balancing with Nginx
* 6 for Kafka, 4 for Redis, 4 for email delivery
C'est un monolithe en cours de transformation !
* automatisation et le déploiement continu des centaines de fois par jour
* déjà quelques microservices
* mais des difficultés de scalabilité pour les BDDs
* et d'adaptation aux spécificités locales
Aujourd'hui :
* 75 millions de membres inscrits dans plus de 18 pays
* 1 milliard d'articles en 2024.
* valorisation de 5 milliards d'euros lors d'une vente de parts en 2024.
### Le point important
75 millions de membres, et **toujours largement un monolithe**.
« Grand système » ne veut pas dire « microservices ».
## Les défis du C2C
### Chaque article est unique
Amazon vend 10 000 fois la même référence. Vinted vend 1 milliard d'objets **tous différents**, photographiés par des amateurs, décrits en texte libre.
Conséquence : pas de catalogue produit. La recherche devient un problème d'indexation et de vision par ordinateur, pas de base relationnelle.
### La confiance entre inconnus
Ni l'acheteur ni le vendeur ne connaissent l'autre.
Il faut donc : le paiement séquestré jusqu'à réception, la détection de fraude, la modération des annonces, la gestion des litiges — à l'échelle de millions de transactions.
C'est du logiciel, pas du service client.
### Le local est partout
18 pays : autant de langues, de moyens de paiement, de transporteurs, de règles fiscales et de régulations.
Une même fonctionnalité doit exister en 18 variantes — sans dupliquer 18 fois le code.
### Et les pics
Rentrée, soldes, campagnes : le trafic ne monte pas régulièrement, il double en une soirée.
Le dimensionnement pour le pic coûte cher le reste de l'année. C'est exactement le problème de Jean, multiplié par 75 millions.
Jean embauche
L'entreprise marche. Jean recrute trois personnes.
Personne ne touche plus au même fichier sans se marcher dessus.
### La loi de Conway (1967)
> Toute organisation qui conçoit un système produira une conception dont la structure est une copie de la structure de communication de l'organisation.
>
> — Melvin Conway
---
### Autrement dit
Votre architecture ressemblera à votre organigramme, que vous le vouliez ou non.
Les microservices sont **d'abord une réponse organisationnelle**, et seulement ensuite une réponse technique.
Si vous retenez une seule chose de la partie qui suit, c'est celle-là.
Microservices
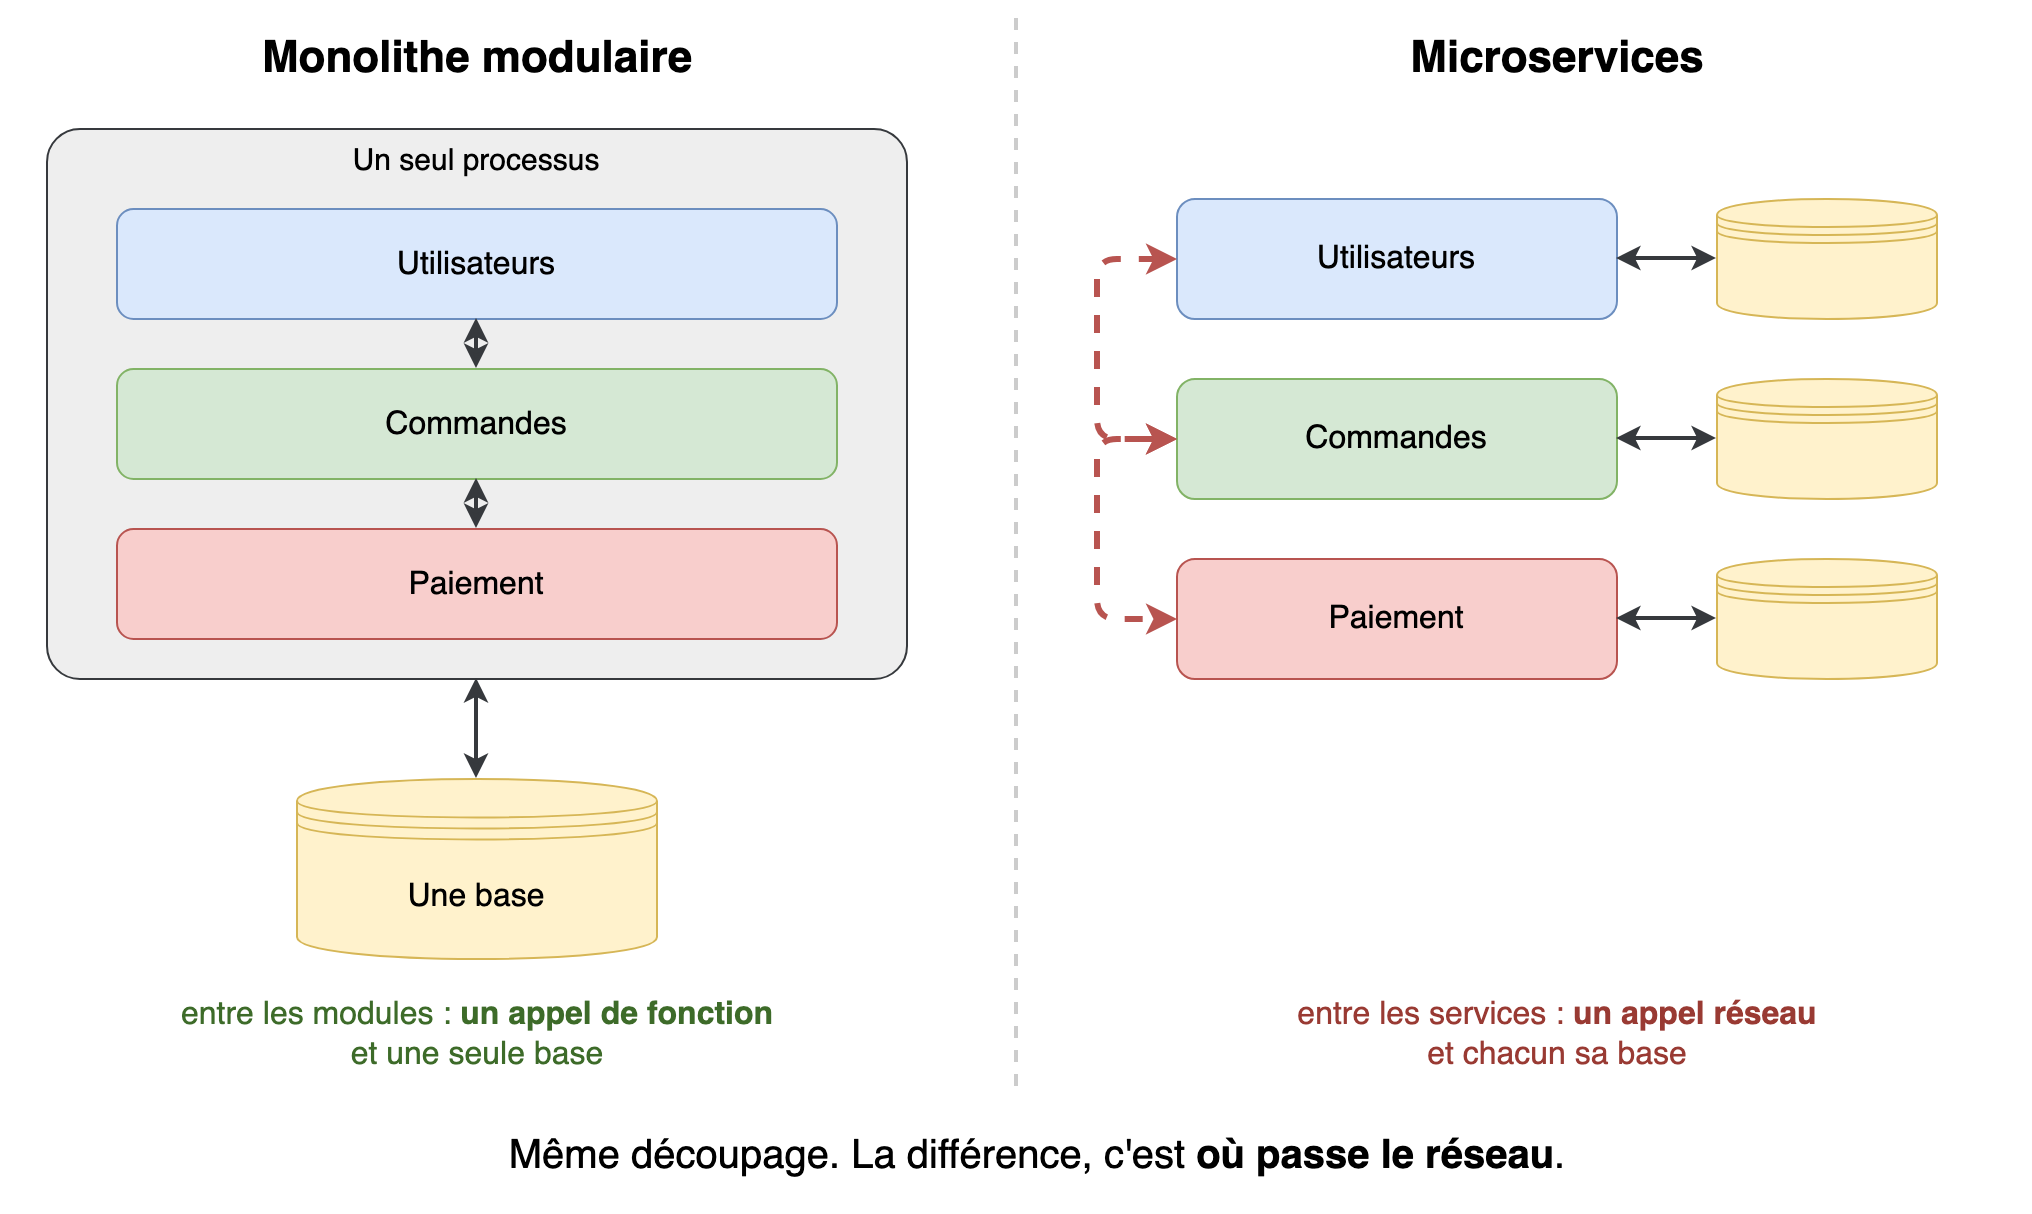
L'architecture microservices structure une application comme une collection de services petits, autonomes et faiblement couplés. Chaque microservice se concentre sur une fonctionnalité métier et peut être développé, déployé et mis à l'échelle indépendamment.
Ils communiquent via des interfaces standardisées (API REST, bus de messages) et **ne partagent pas leur base de données**.
### Quatre caractéristiques
* **Découpage fonctionnel** — un service par capacité métier (utilisateurs, commandes, stock, paiement).
* **Indépendance** — une équipe, un langage, un déploiement propre à chaque service.
* **Faible couplage** — on connaît l'interface du voisin, pas son implémentation.
* **Décentralisation des données** — chacun sa base.
### Ce que ça vous donne, ce que ça vous coûte
| Avantages | Inconvénients |
|---|---|
| On met à l'échelle le seul service surchargé | Il faut gérer des dizaines de services et leurs versions |
| Un service qui tombe n'emporte pas le reste | Suivre une transaction qui traverse 8 services est un métier |
| Les équipes livrent en parallèle, sans se bloquer | Plus de base commune : cohérence éventuelle, sagas, compensations |
| Chaque service choisit sa technologie | Conteneurs, orchestrateur, observabilité : le coût d'entrée est élevé |
### Vous avez remarqué ?
Colonne de gauche : des bénéfices **d'équipe**.
Colonne de droite : des coûts **techniques**.
Conway, encore.
## Le retour de bâton
On vous a probablement présenté les microservices comme l'aboutissement naturel.
Ce n'est pas ce qui s'est passé.
### Segment, 2018
Article *Goodbye Microservices*.
Passés de 3 services à plus de 140, puis **retour à un monolithe** : le coût de maintenance des services et de leurs dépendances dépassait tout ce que le découpage leur apportait.
### Amazon Prime Video, 2023
Le service de contrôle qualité audio/vidéo, construit en microservices serverless, est **repassé en monolithe**.
Résultat annoncé par l'équipe : **90 % de coût d'infrastructure en moins**.
Le coût dominant n'était pas le calcul : c'était le transport des données entre les services.
### Shopify
Un des plus gros Ruby on Rails du monde, assumé comme **monolithe modulaire**.
Frontières internes strictes, un seul déploiement. Les bénéfices d'organisation, sans le réseau entre chaque appel.
### Le monolithe modulaire
Un seul processus, mais des modules aux frontières explicites et interdites de contournement.
C'est aujourd'hui le **défaut raisonnable**.
On sort un module en service quand on a une raison précise — pas par principe.
Le même découpage, deux fois
### Et nous ?
**Jumplyn** :
* 1 dépôt, 7 applications web, 1 base de données
* 5 processus : l'API (× 3), le fond, le temps réel, les mails, la surveillance
* 1 serveur, 1 proxy, **1 commande de déploiement**
Découpé par **raison d'être**, pas par entité métier. Aucun n'a sa propre base.
Segment, Prime Video, Shopify. Et nous.
### Comment choisir
| Vous avez... | Prenez... |
|---|---|
| 1 à 3 équipes | un monolithe (modulaire) |
| une partie qui scale 10× plus que le reste | ce module en service |
| des équipes qui se bloquent au déploiement | découpez selon Conway |
| « c'est plus moderne » | rien du tout |
**La complexité distribuée est un coût qu'on paie pour une raison, pas un badge.**
## Les outils
---
### Le paysage
| Rôle | Exemples |
|---|---|
| Conteneurs | Docker |
| Orchestrateurs | Kubernetes |
| Infrastructure as Code | Terraform, Ansible |
| Service Mesh | Istio, Linkerd |
| Bus de messages | RabbitMQ, Kafka |
| CI / CD | GitLab CI, GitHub Actions |
| Observabilité | Prometheus, Grafana, ELK |
| CDN | Cloudflare, Akamai |
Vous n'allez pas en retenir huit. Retenez-en deux — ceux que vous allez manipuler.
---
### Les conteneurs
Un conteneur emballe une application **et toutes ses dépendances** dans une unité standardisée.
Ce qu'il résout : « ça marche sur ma machine ».
Vous en lancerez un cluster complet en TD3 — c'est un `docker compose up`.
---
### Le calcul distribué
Quand les données ne tiennent plus sur une machine, c'est le calcul qui va vers elles.
Spark découpe le travail, l'envoie aux machines qui détiennent déjà les données, et ne rapatrie que les résultats.
C'est le TD3 — et c'est là que vous verrez ce que coûte vraiment le réseau.
## Penser les systèmes distribués
Construire des systèmes distribués, c'est accepter une réalité : les pannes sont inévitables.
* Un disque dur va tomber.
* Un réseau va être saturé.
* Un service va planter.
L'objectif n'est pas d'empêcher les pannes, mais de construire des systèmes résilients qui continuent de fonctionner malgré les pannes.
C'est la différence fondamentale entre l'informatique "classique" et les grands systèmes.
### On ne l'a pas subie, on l'a provoquée
Sur Jumplyn, on éteint la production pour voir.
| Date | Découvert |
|---|---|
| 26/05/2023 | base non redémarrée, droits du proxy, aucun log, API à terre |
| 02/06/2023 | ping 1 min 45 · proxy 1 min 50 · API 2 min 32 |
| | **et le serveur n'est pas remonté** |
### Ce que la simulation a produit
Rien de tout cela n'était dans la documentation **avant**.
C'est la panne provoquée qui l'a écrite — et c'est moins cher que celle qu'on subit.
### Les 8 sophismes du calcul distribué
L. Peter Deutsch (Sun, 1994), complété par James Gosling (1997).
Huit hypothèses que **tout le monde fait**, et qui sont **toutes fausses**.
### La liste
1. Le réseau est fiable
2. La latence est nulle
3. La bande passante est infinie
4. Le réseau est sûr
5. La topologie ne change pas
6. Il y a un seul administrateur
7. Le transport ne coûte rien
8. Le réseau est homogène
*(souvent ajoutée : il existe une horloge commune)*
### C'est le plan de la matière
| Sophisme | La séance qui le démonte |
|---|---|
| Le réseau est fiable | TD2 — Scraping |
| Latence nulle / transport gratuit | TD3 — Spark |
| Bande passante infinie | TD3 — Spark |
| Le réseau est homogène | Cours 2 + TD1 — RPC |
| Il existe une horloge commune | TD4 — Horloges |
| Il y a un seul administrateur | Cours 4 — P2P |
| La topologie ne change pas | TD6 — DHT |
| Le réseau est sûr | Cours 5 + TD7 — Bitcoin |
Chaque séance vous retire une hypothèse. Il n'en reste aucune à la fin.
### « Le réseau est fiable »
En TD2, votre scraper va casser. Pas avec une erreur : **en silence**.
Quelqu'un aura refait une partie du site, votre programme continuera de tourner et rendra des résultats vides.
Un système distribué ne vous prévient pas qu'il est cassé. C'est à vous de le détecter.
### « La latence est nulle »
Jean vend maintenant au Japon.
Un aller-retour Paris–Tokyo, c'est ~250 ms **au mieux** — et la vitesse de la lumière n'est pas négociable.
Trente appels séquentiels à travers le Pacifique, et votre page met 8 secondes à s'afficher.
### Les ordres de grandeur
| Opération | Temps |
|---|---|
| Référence cache L1 | 0,5 ns |
| Mauvaise prédiction de branchement | 5 ns |
| Référence cache L2 | 7 ns |
| Lock/unlock d'un mutex | 25 ns |
| Référence mémoire principale | 100 ns |
| Compresser 1 Ko avec Zippy | 3 000 ns |
| Envoyer 1 Ko sur un réseau 1 Gbps | 10 000 ns |
### Les ordres de grandeur
| Opération | Temps |
|---|---|
| Lire 4 Ko aléatoires sur SSD | 150 000 ns |
| Lire 1 Mo séquentiel en mémoire | 250 000 ns |
| **Aller-retour dans le même datacenter** | **500 000 ns** |
| Lire 1 Mo séquentiel sur SSD | 1 000 000 ns |
### Les ordres de grandeur
| Opération | Temps |
|---|---|
| Déplacement de tête de disque | 10 000 000 ns |
| Lire 1 Mo séquentiel sur disque | 20 000 000 ns |
| **Paquet Californie → Pays-Bas → Californie** | **150 000 000 ns** |
[gist.github.com/jboner/2841832](https://gist.github.com/jboner/2841832)
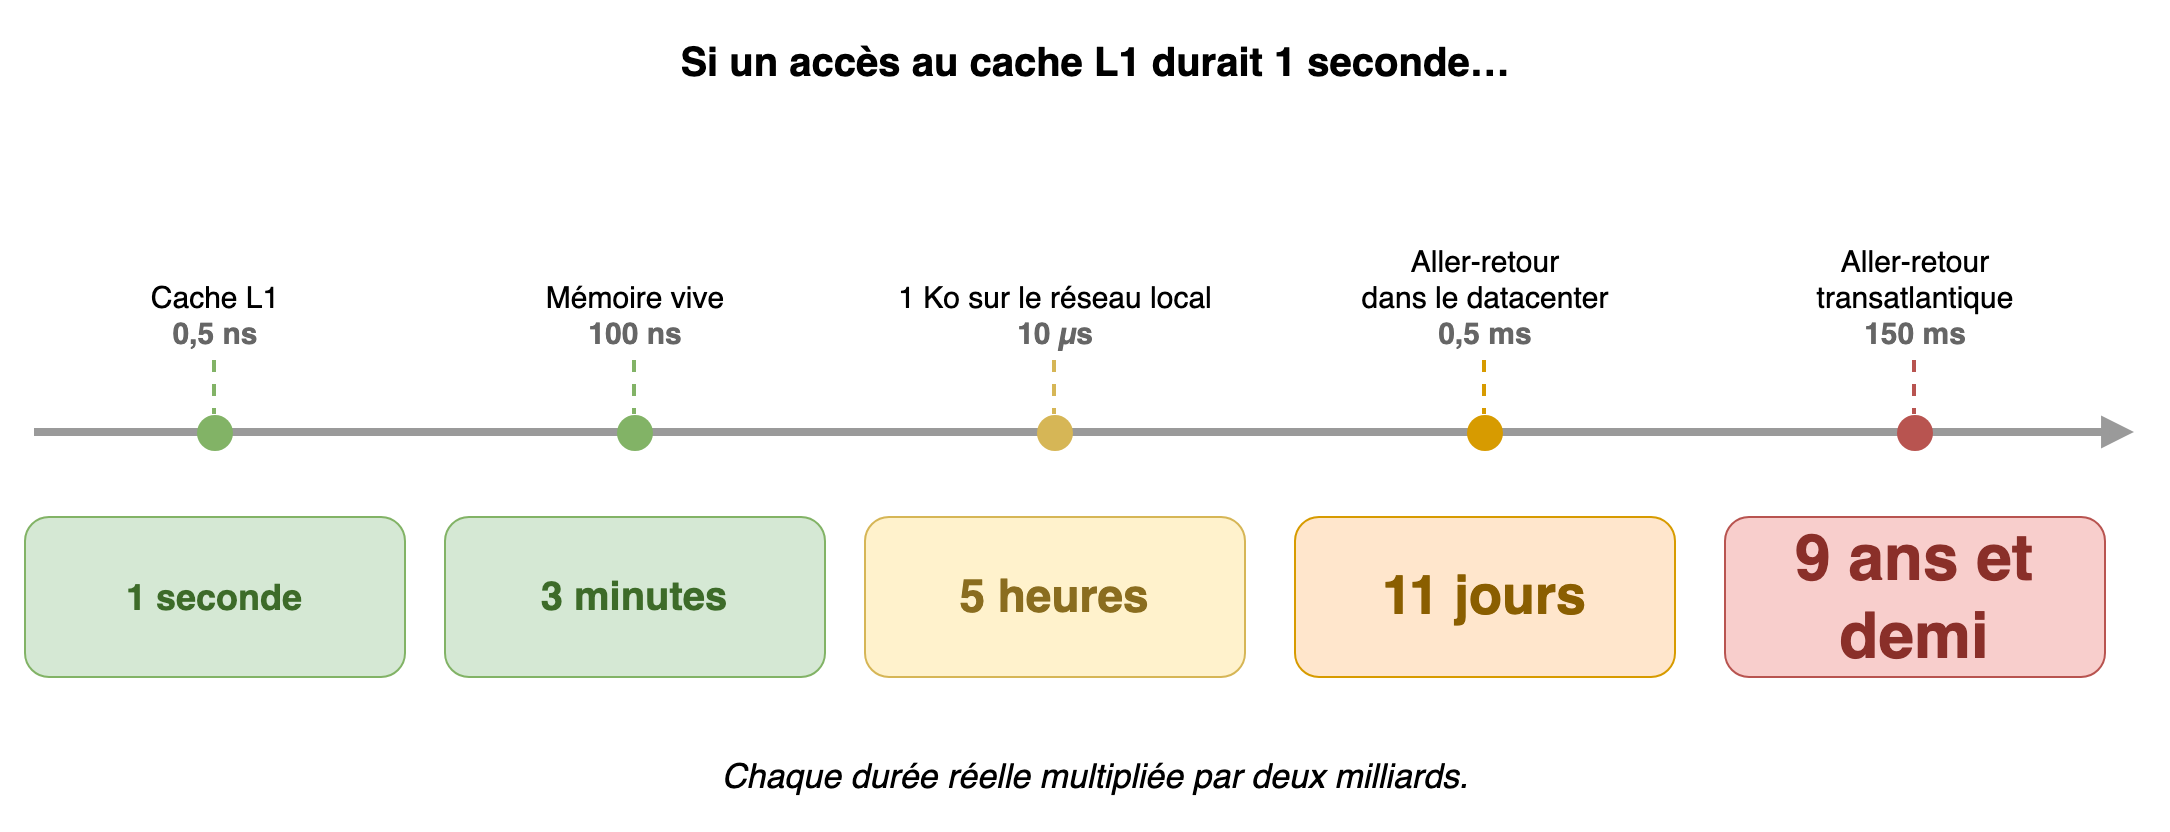
À l'échelle humaine
### Ce que dit ce tableau
Un aller-retour dans le même datacenter coûte **5 000 fois** un accès mémoire.
Un aller-retour transatlantique en coûte **1 500 000**.
Découper un monolithe en microservices, c'est remplacer des appels de fonction par des allers-retours réseau. Le tableau vous dit le prix.
### La réponse : rapprocher les données
* **Cache** — garder près de soi ce qu'on vient de lire
* **CDN** — copier le statique près des utilisateurs
* **Réplication** — plusieurs copies, pour la disponibilité
* **Partitionnement** — découper les données entre machines
Chacune crée le même problème : **plusieurs copies, qui peuvent être en désaccord.**
## Data
Depuis le pic de charge, Jean a deux serveurs.
Donc deux copies de ses commandes.
### Les familles de BDD, rangées par quantité de réseau
* **embarquée** (SQLite) — zéro réseau
* **service** (PostgreSQL) — un aller-retour
* **distribuée** (Cassandra) — plusieurs machines qui doivent s'accorder
Relationnel, NoSQL, en mémoire : c'est un autre débat, et pas celui de ce cours.
Jean est passé de la première ligne à la troisième **sans l'avoir décidé**.
### ACID
Les bases relationnelles garantissent quatre propriétés :
* **A**tomicity — tout ou rien
* **C**onsistency — les contraintes restent vraies
* **I**solation — les transactions concurrentes ne se voient pas
* **D**urability — ce qui est validé survit à la panne
Sur une machine, c'est un problème résolu depuis quarante ans.
### Et sur plusieurs machines ?
Répliquer ou partitionner (sharding) oblige à préserver ces propriétés **à travers le réseau**.
C'est là que tout devient difficile.
### Commit à 2 puis 3 phases
Un coordinateur demande à tous les nœuds : « pouvez-vous valider ? ». Si tous répondent oui, il ordonne la validation.
Le 3-phase commit ajoute une phase de pré-validation, avec un journal durable.
**Le défaut : c'est bloquant.** Si le coordinateur meurt au mauvais moment, la ressource reste verrouillée.
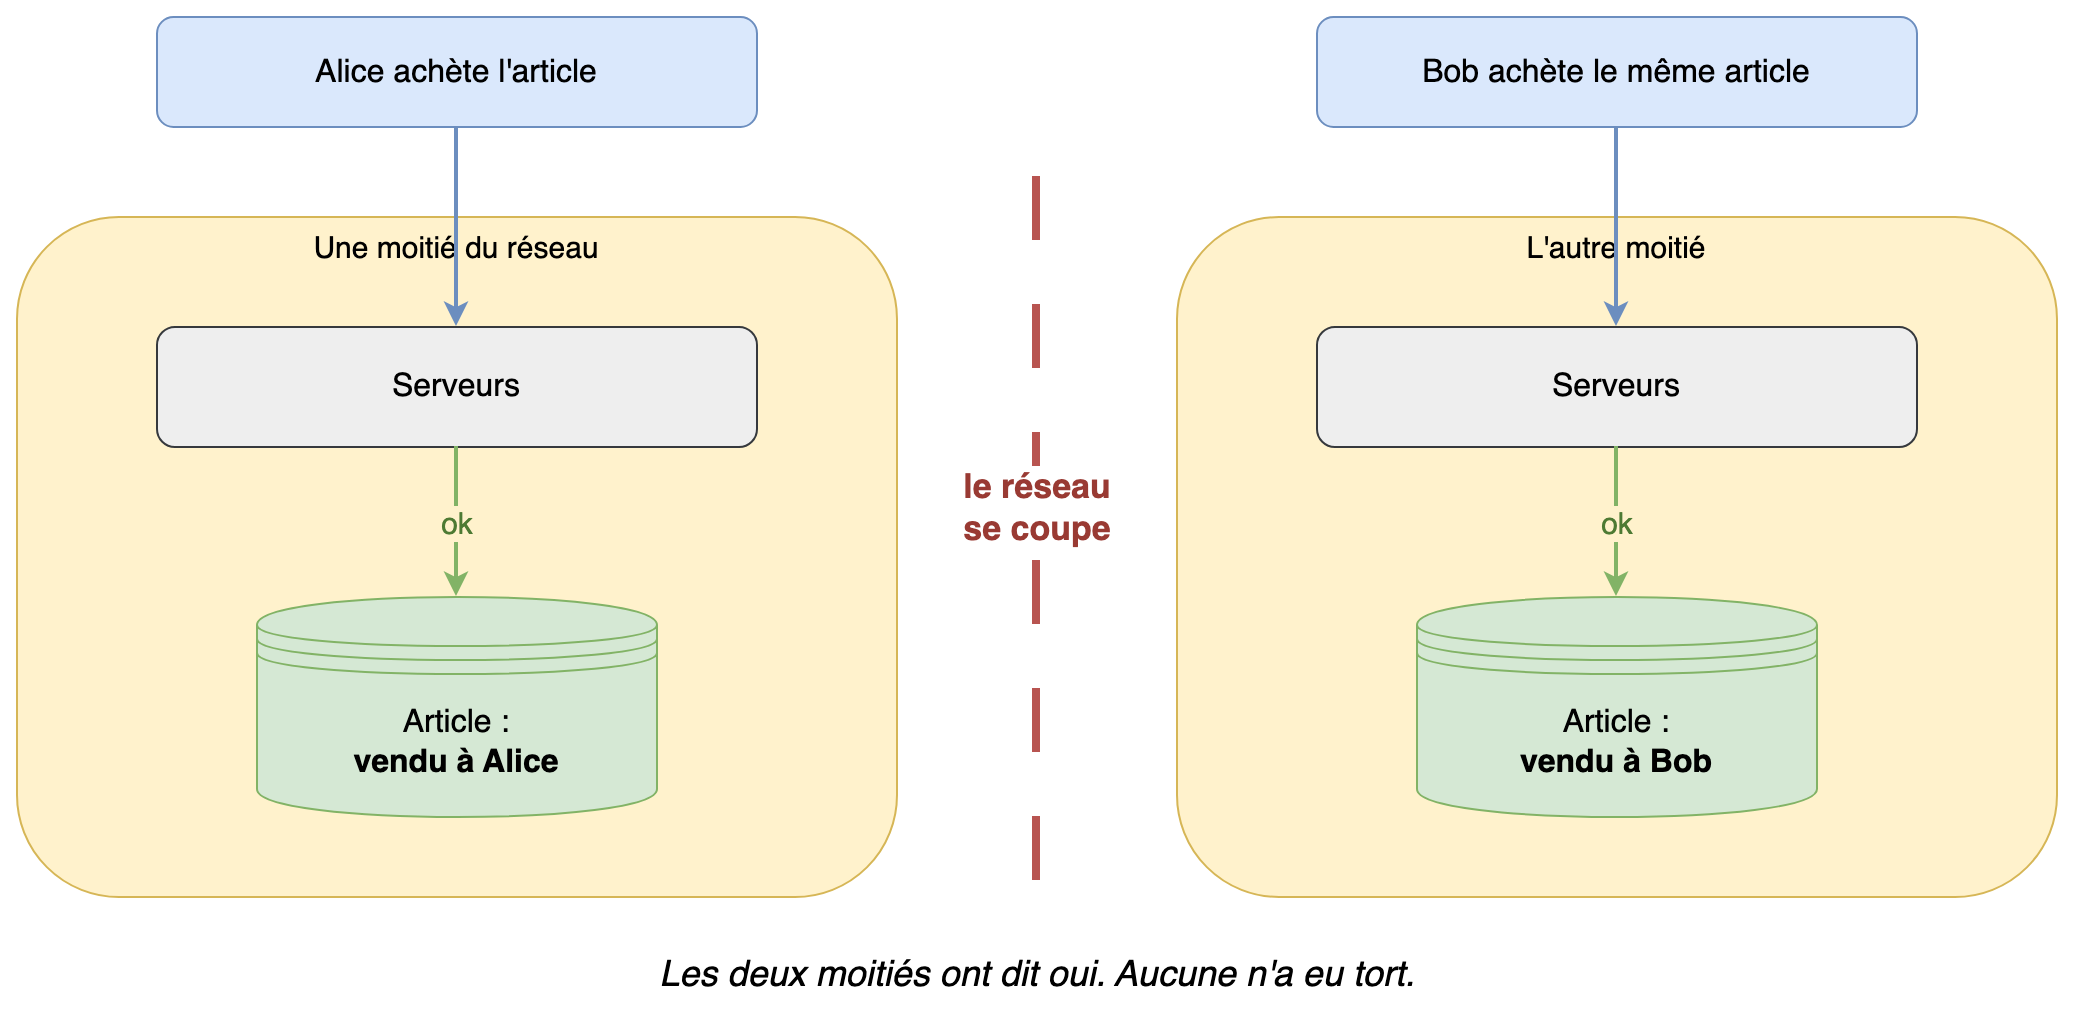
### Et si le réseau se coupe en deux ?
Les deux moitiés continuent de tourner. Les deux acceptent des écritures.
Quand le réseau revient, laquelle avait raison ?
Un article, deux acheteurs
### Je m'arrête ici
Répondre à cette question, c'est **le consensus** : le Cours 3 et le TD5 de mon binôme.
C'est un cours entier, pas une slide.
Ce que je voulais que vous voyiez aujourd'hui, c'est **d'où vient le besoin**. Il vient des deux slides précédentes.
## IA
### L'IA est un grand système distribué
Entraîner un modèle, c'est le même problème qu'aujourd'hui, en plus dur :
* les données ne tiennent pas sur une machine → partitionnement
* le modèle non plus → parallélisme de modèle
* des milliers de GPU doivent synchroniser leurs gradients → bande passante et coordination
* une machine tombe toutes les quelques heures → tolérance aux pannes, points de reprise
Vous savez déjà nommer chacun de ces problèmes.
### Et servir le modèle aussi
Répartition de charge, cache (des préfixes de conversation), latence perçue, coût au million de requêtes, régions géographiques.
Ce sont exactement les slides d'il y a vingt minutes.
## Pour finir
### Ce qu'on a fait en deux heures
Jean Dupont a vendu un t-shirt, puis dix mille, puis au Japon, puis a embauché.
À chaque étape il a perdu une certitude — et gagné un chapitre de la matière.
Il vous reste sept séances pour lui retirer les autres.
### La question que je vous laisse
[**Faut-il tout stocker ?**](https://home.cern/fr/about/computing/processing-what-record)
Le LHC produit bien plus de données qu'on ne peut en écrire. Le tri se fait **avant** l'enregistrement : la majorité des collisions est jetée définitivement.
Décider ce qu'on ne garde pas est une décision d'architecture — et une décision politique.
> There are only two hard things in Computer Science: cache invalidation and naming things.
>
> — Phil Karlton
> There are only two hard problems in distributed systems:
> 2. Exactly-once delivery
> 1. Guaranteed order of messages
> 2. Exactly-once delivery
>
> — Mathias Verraes
### Trois références
* **Martin Kleppmann**, *Designing Data-Intensive Applications* — le livre de référence sur le sujet. Si vous n'en lisez qu'un, c'est celui-là.
* **Tanenbaum & Van Steen**, *Distributed Systems* — le manuel académique, disponible gratuitement en PDF sur [distributed-systems.net](https://www.distributed-systems.net/index.php/books/ds4/).
* **Michael Nygard**, *Release It!* — ce qui casse en production, et pourquoi.
Et un signet : [les latences de jboner](https://gist.github.com/jboner/2841832).
## Questions ?